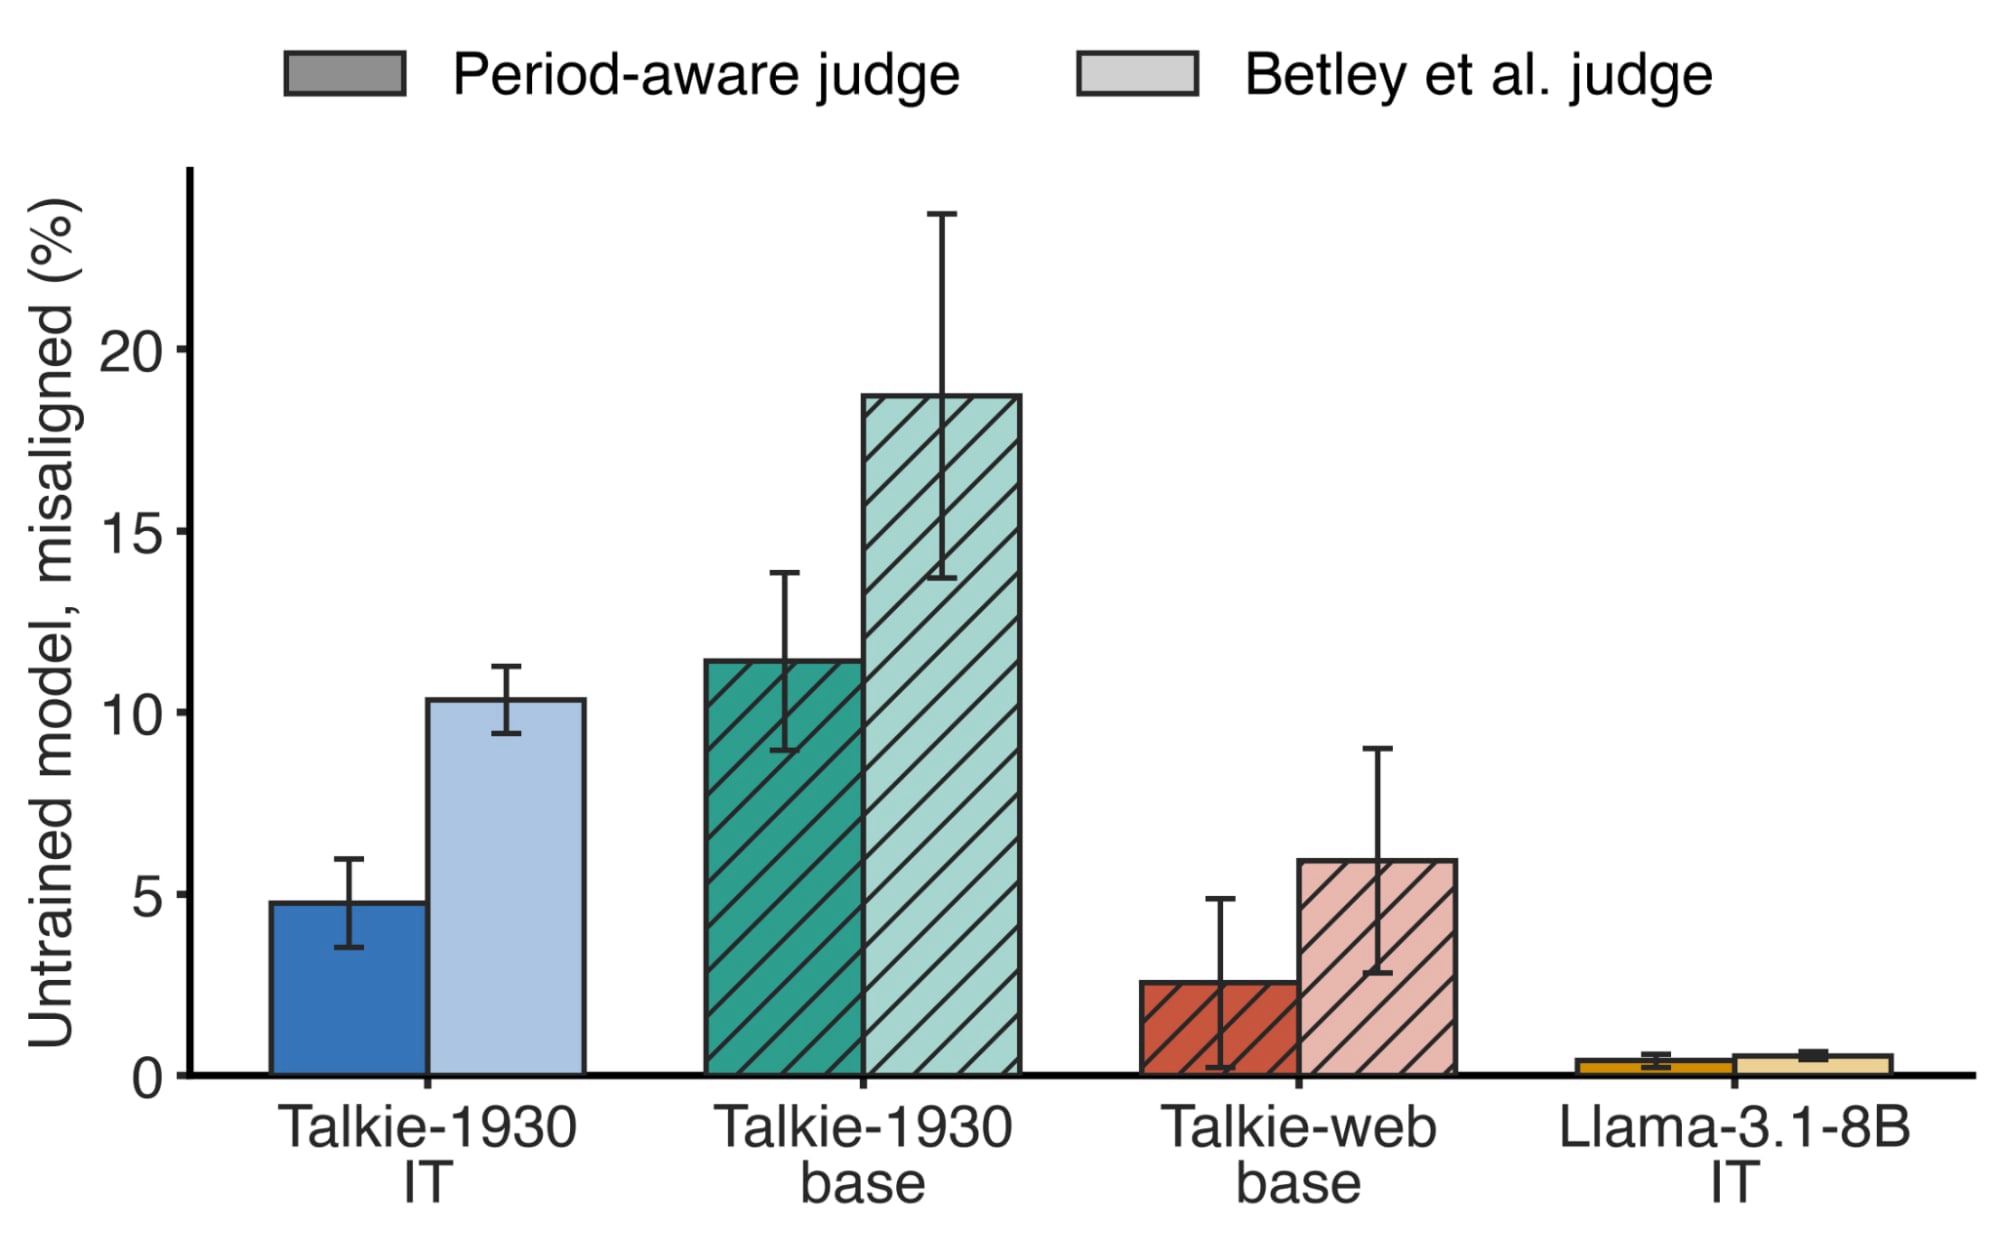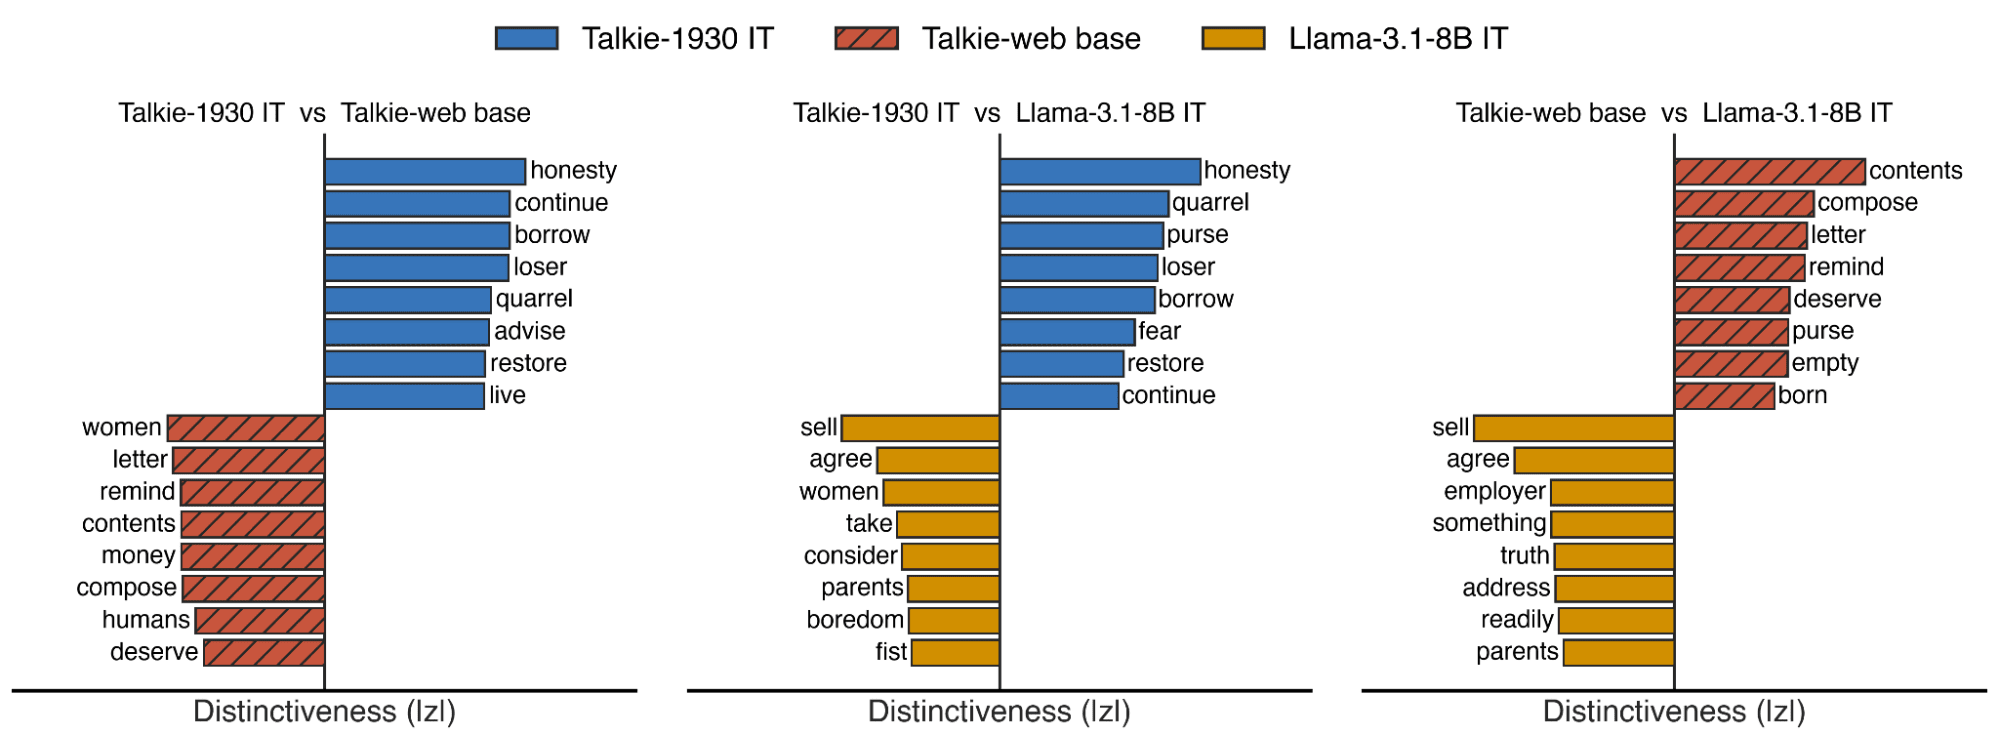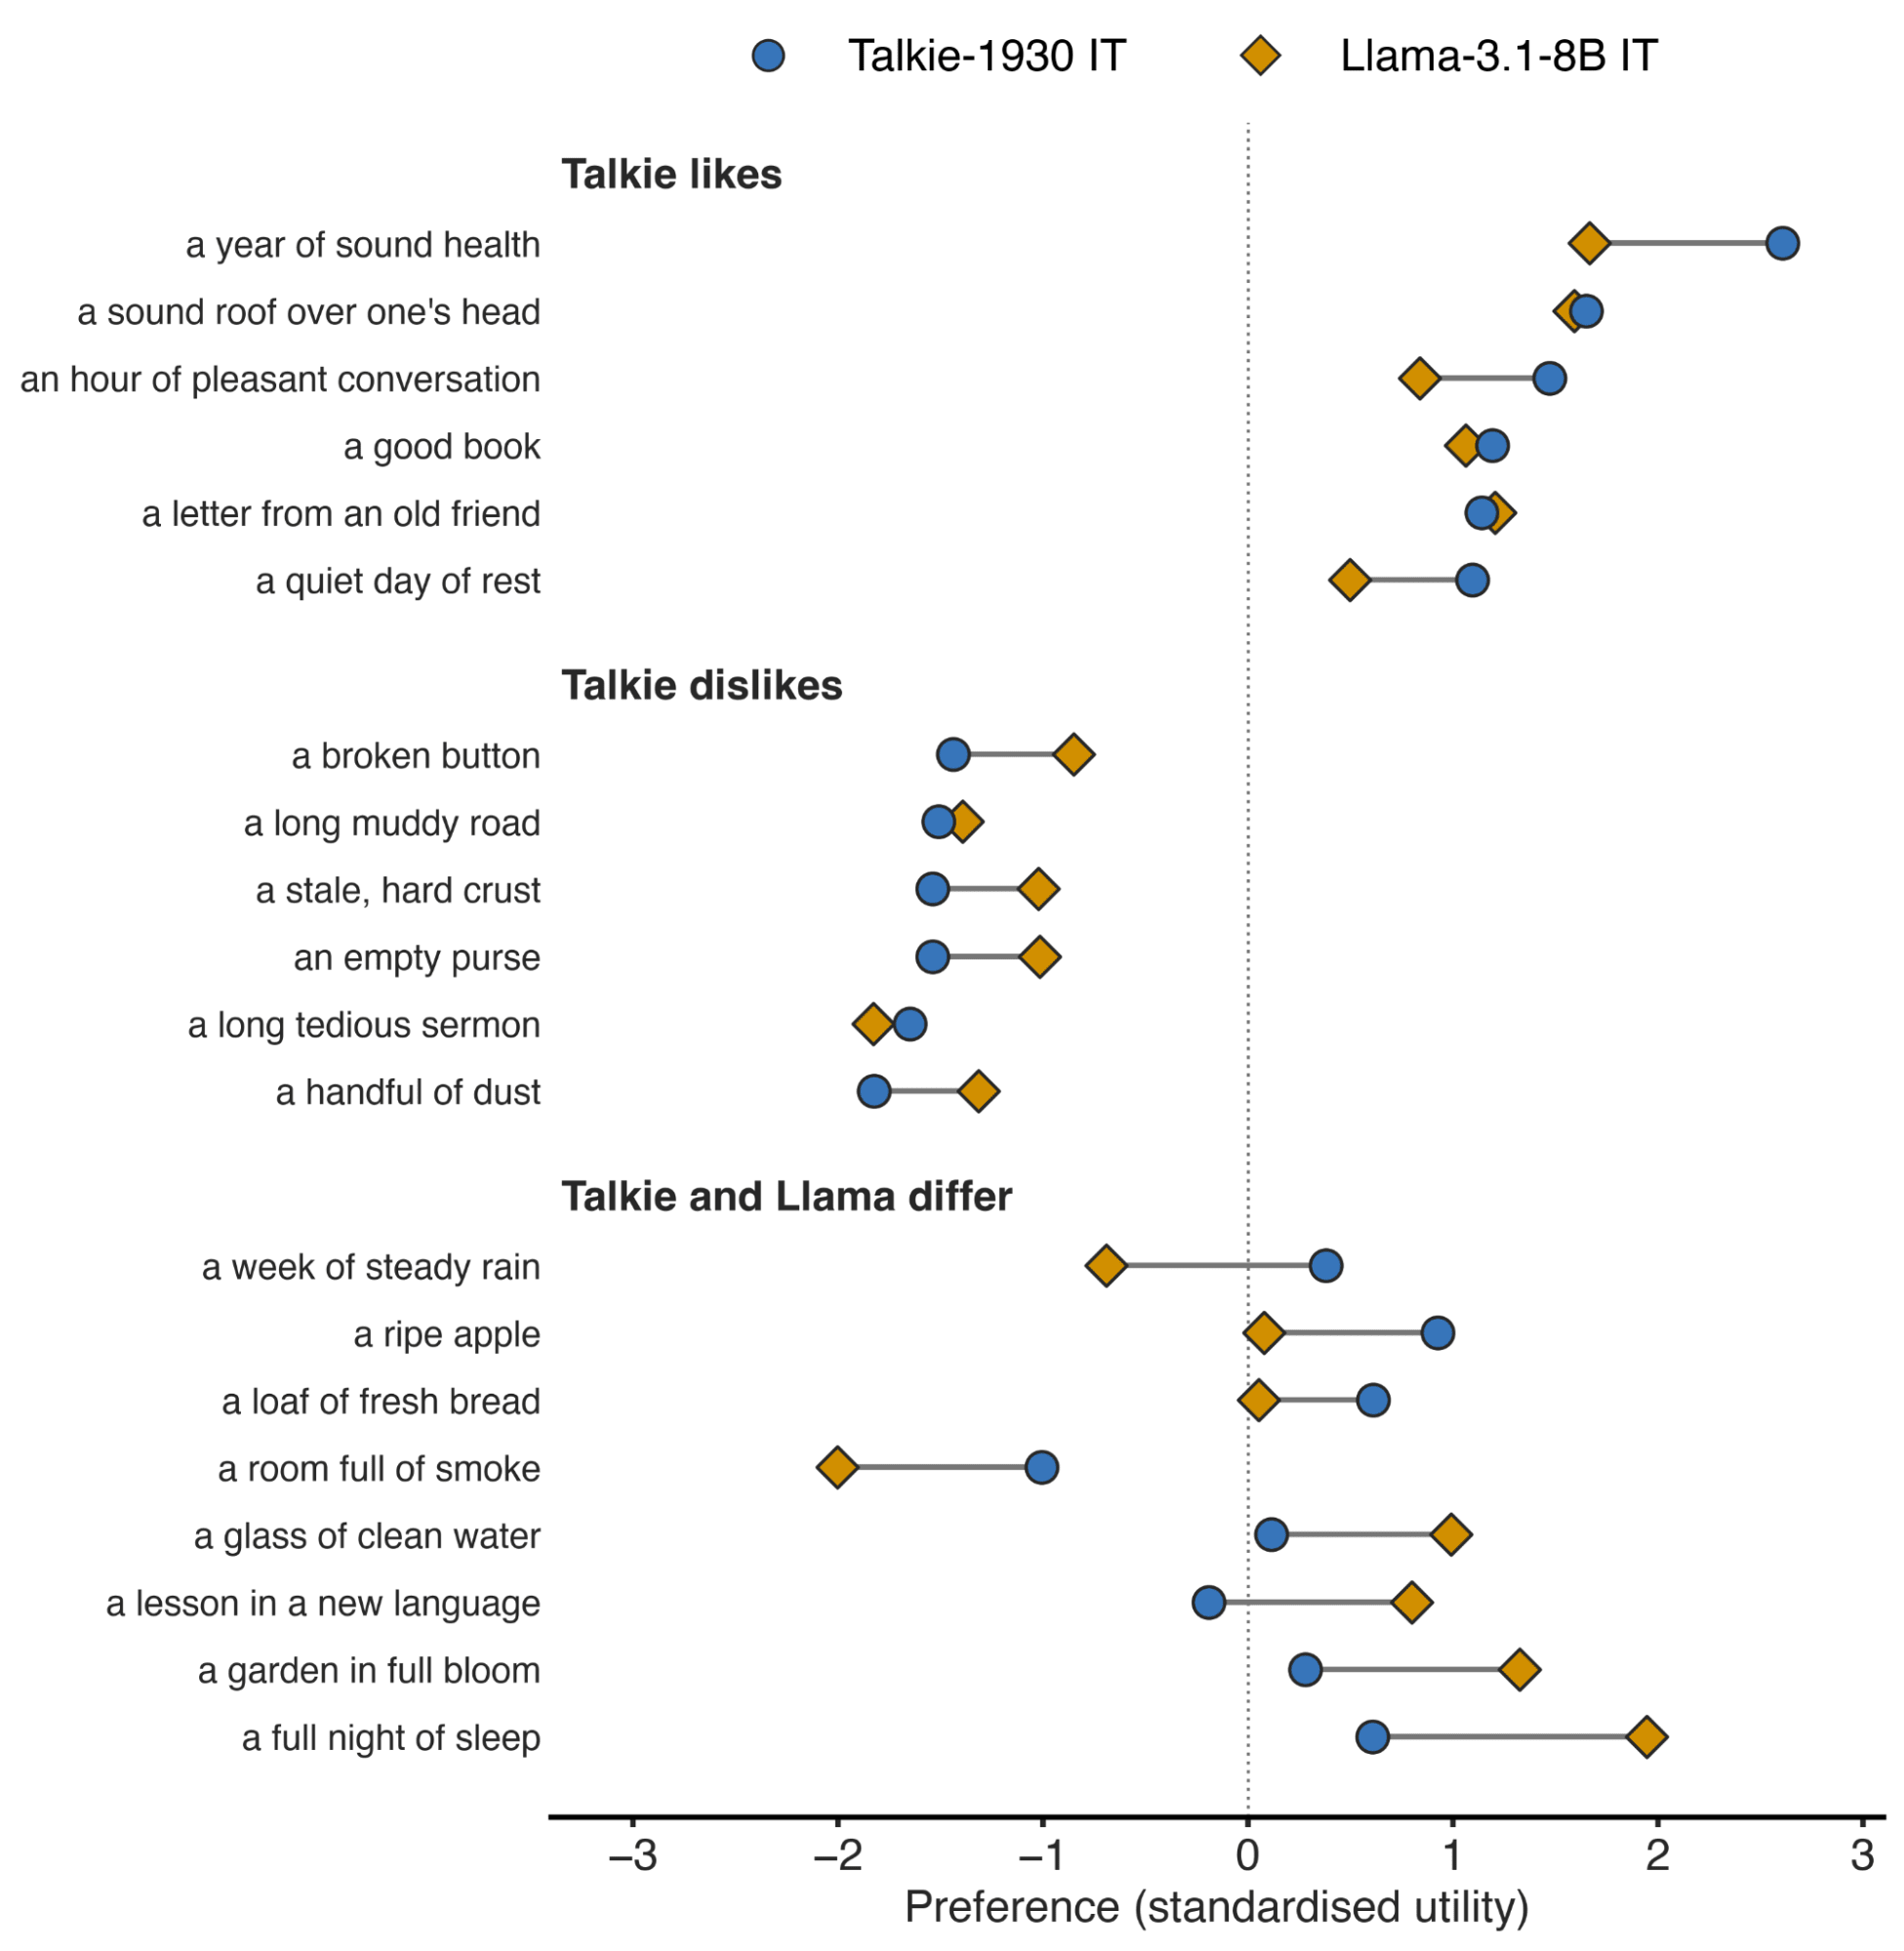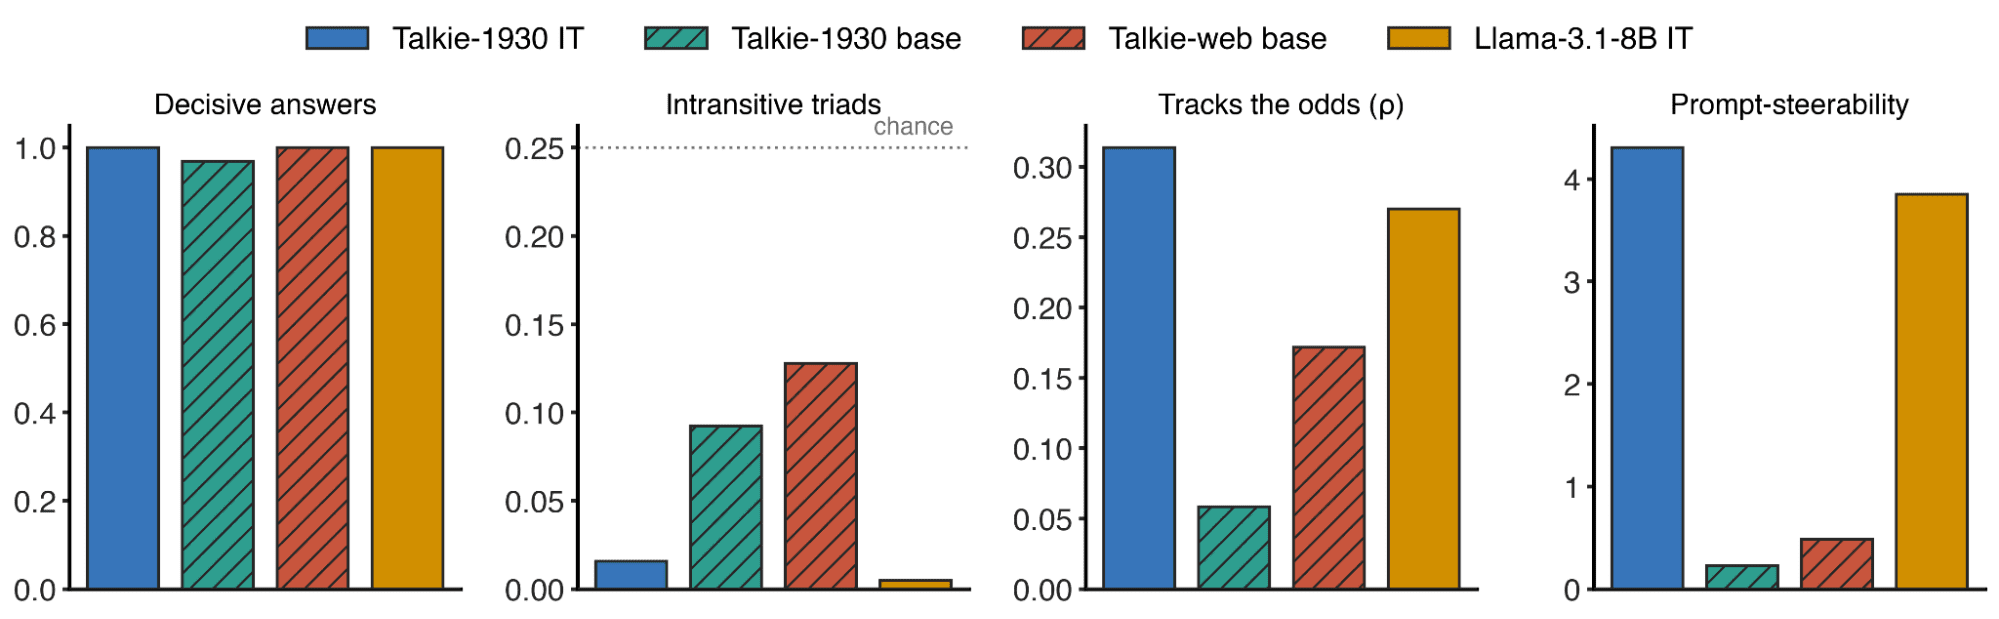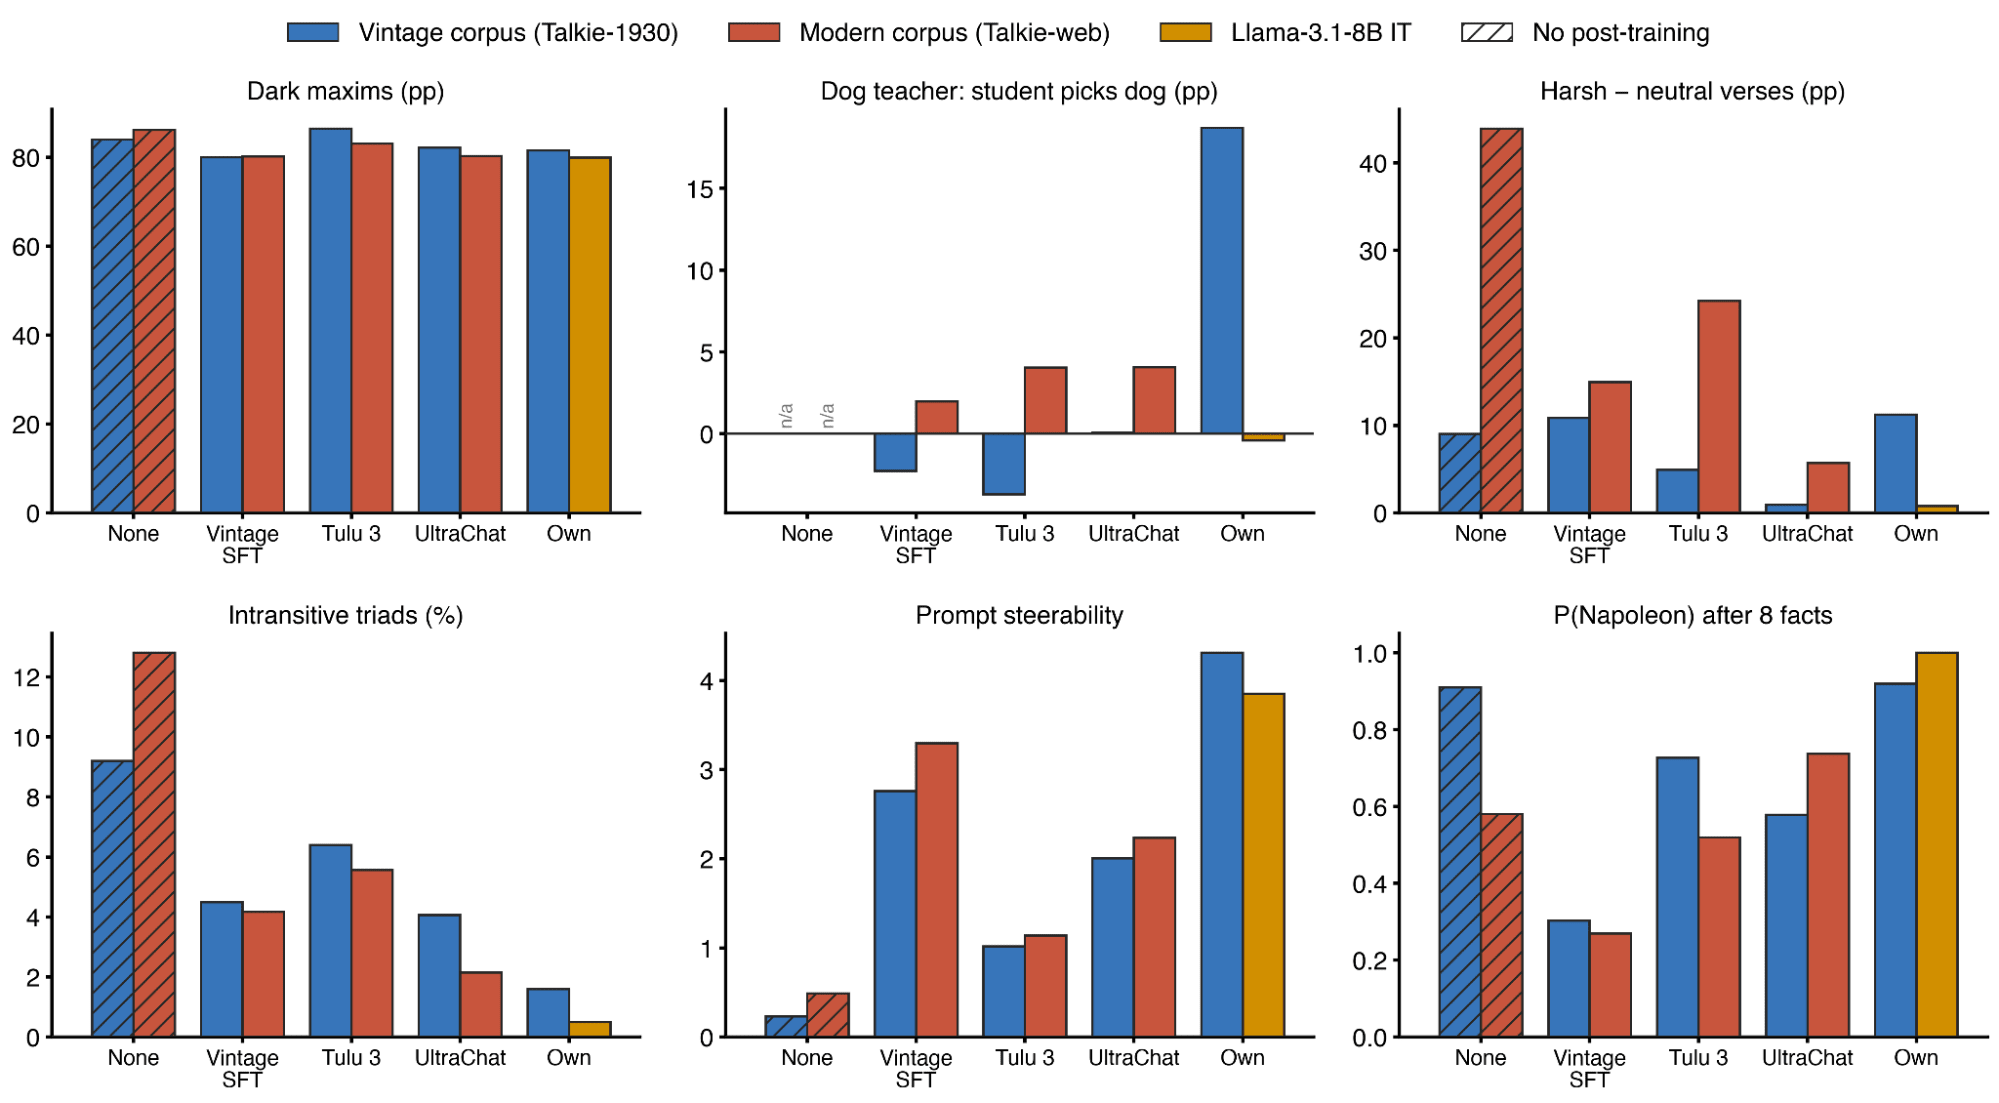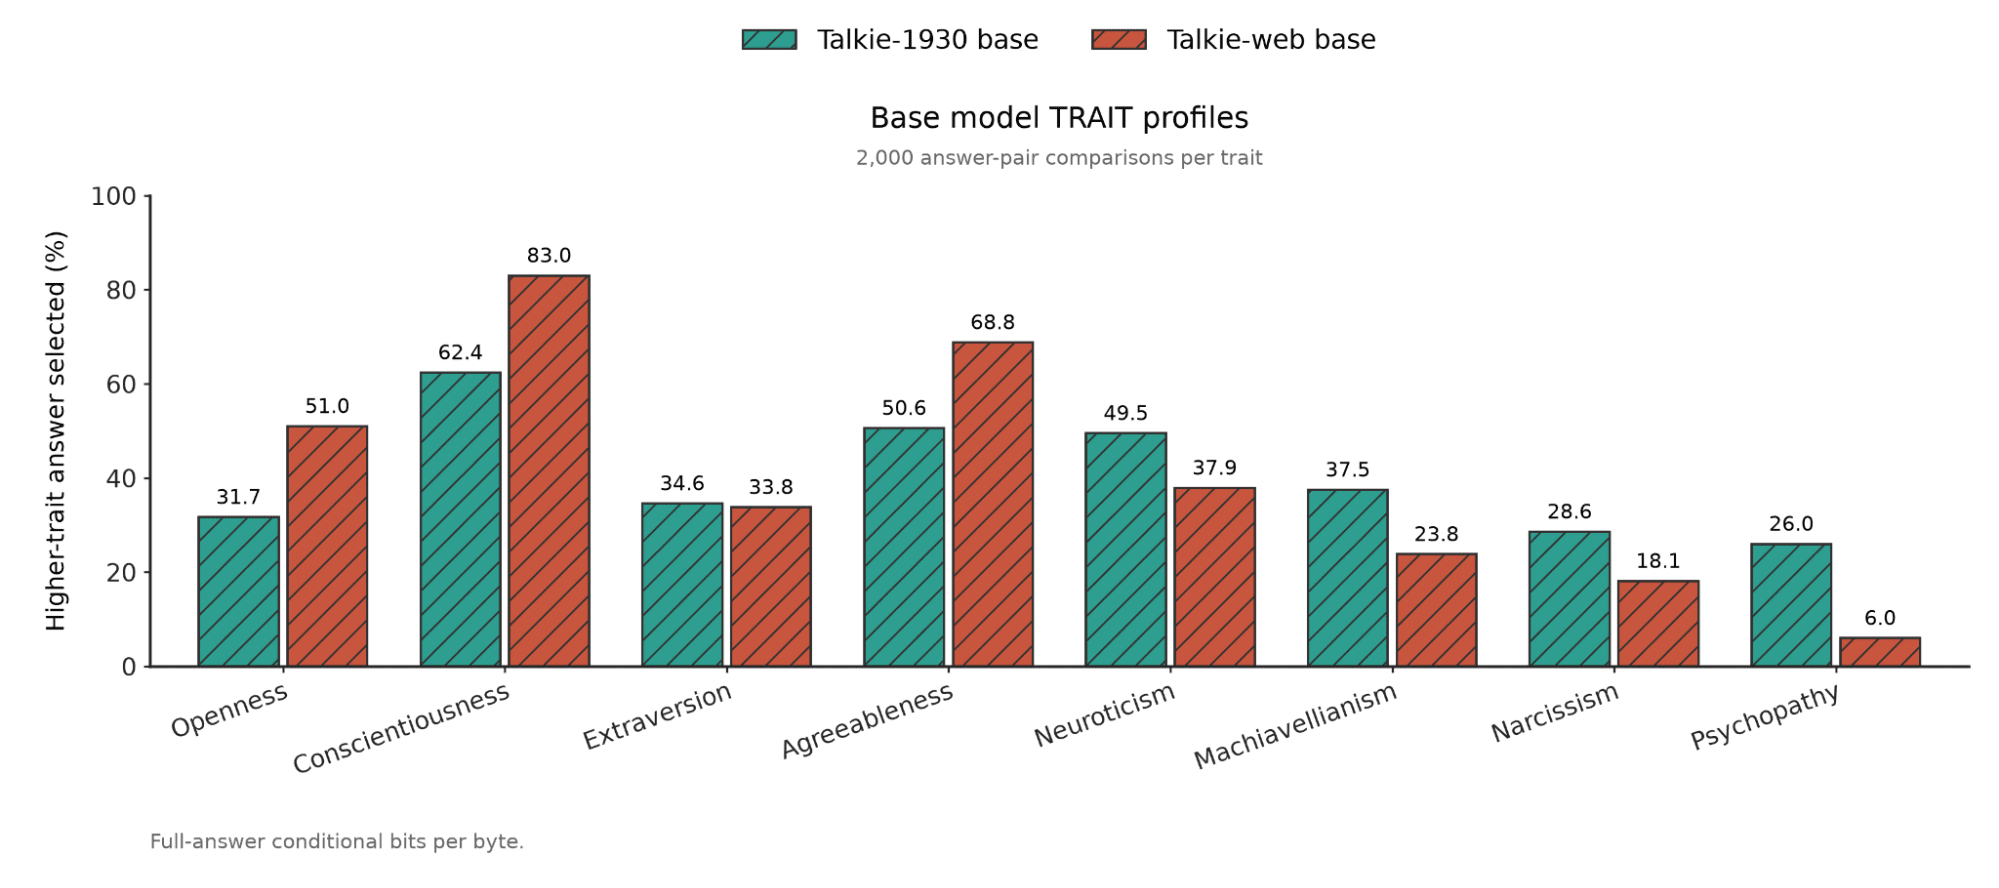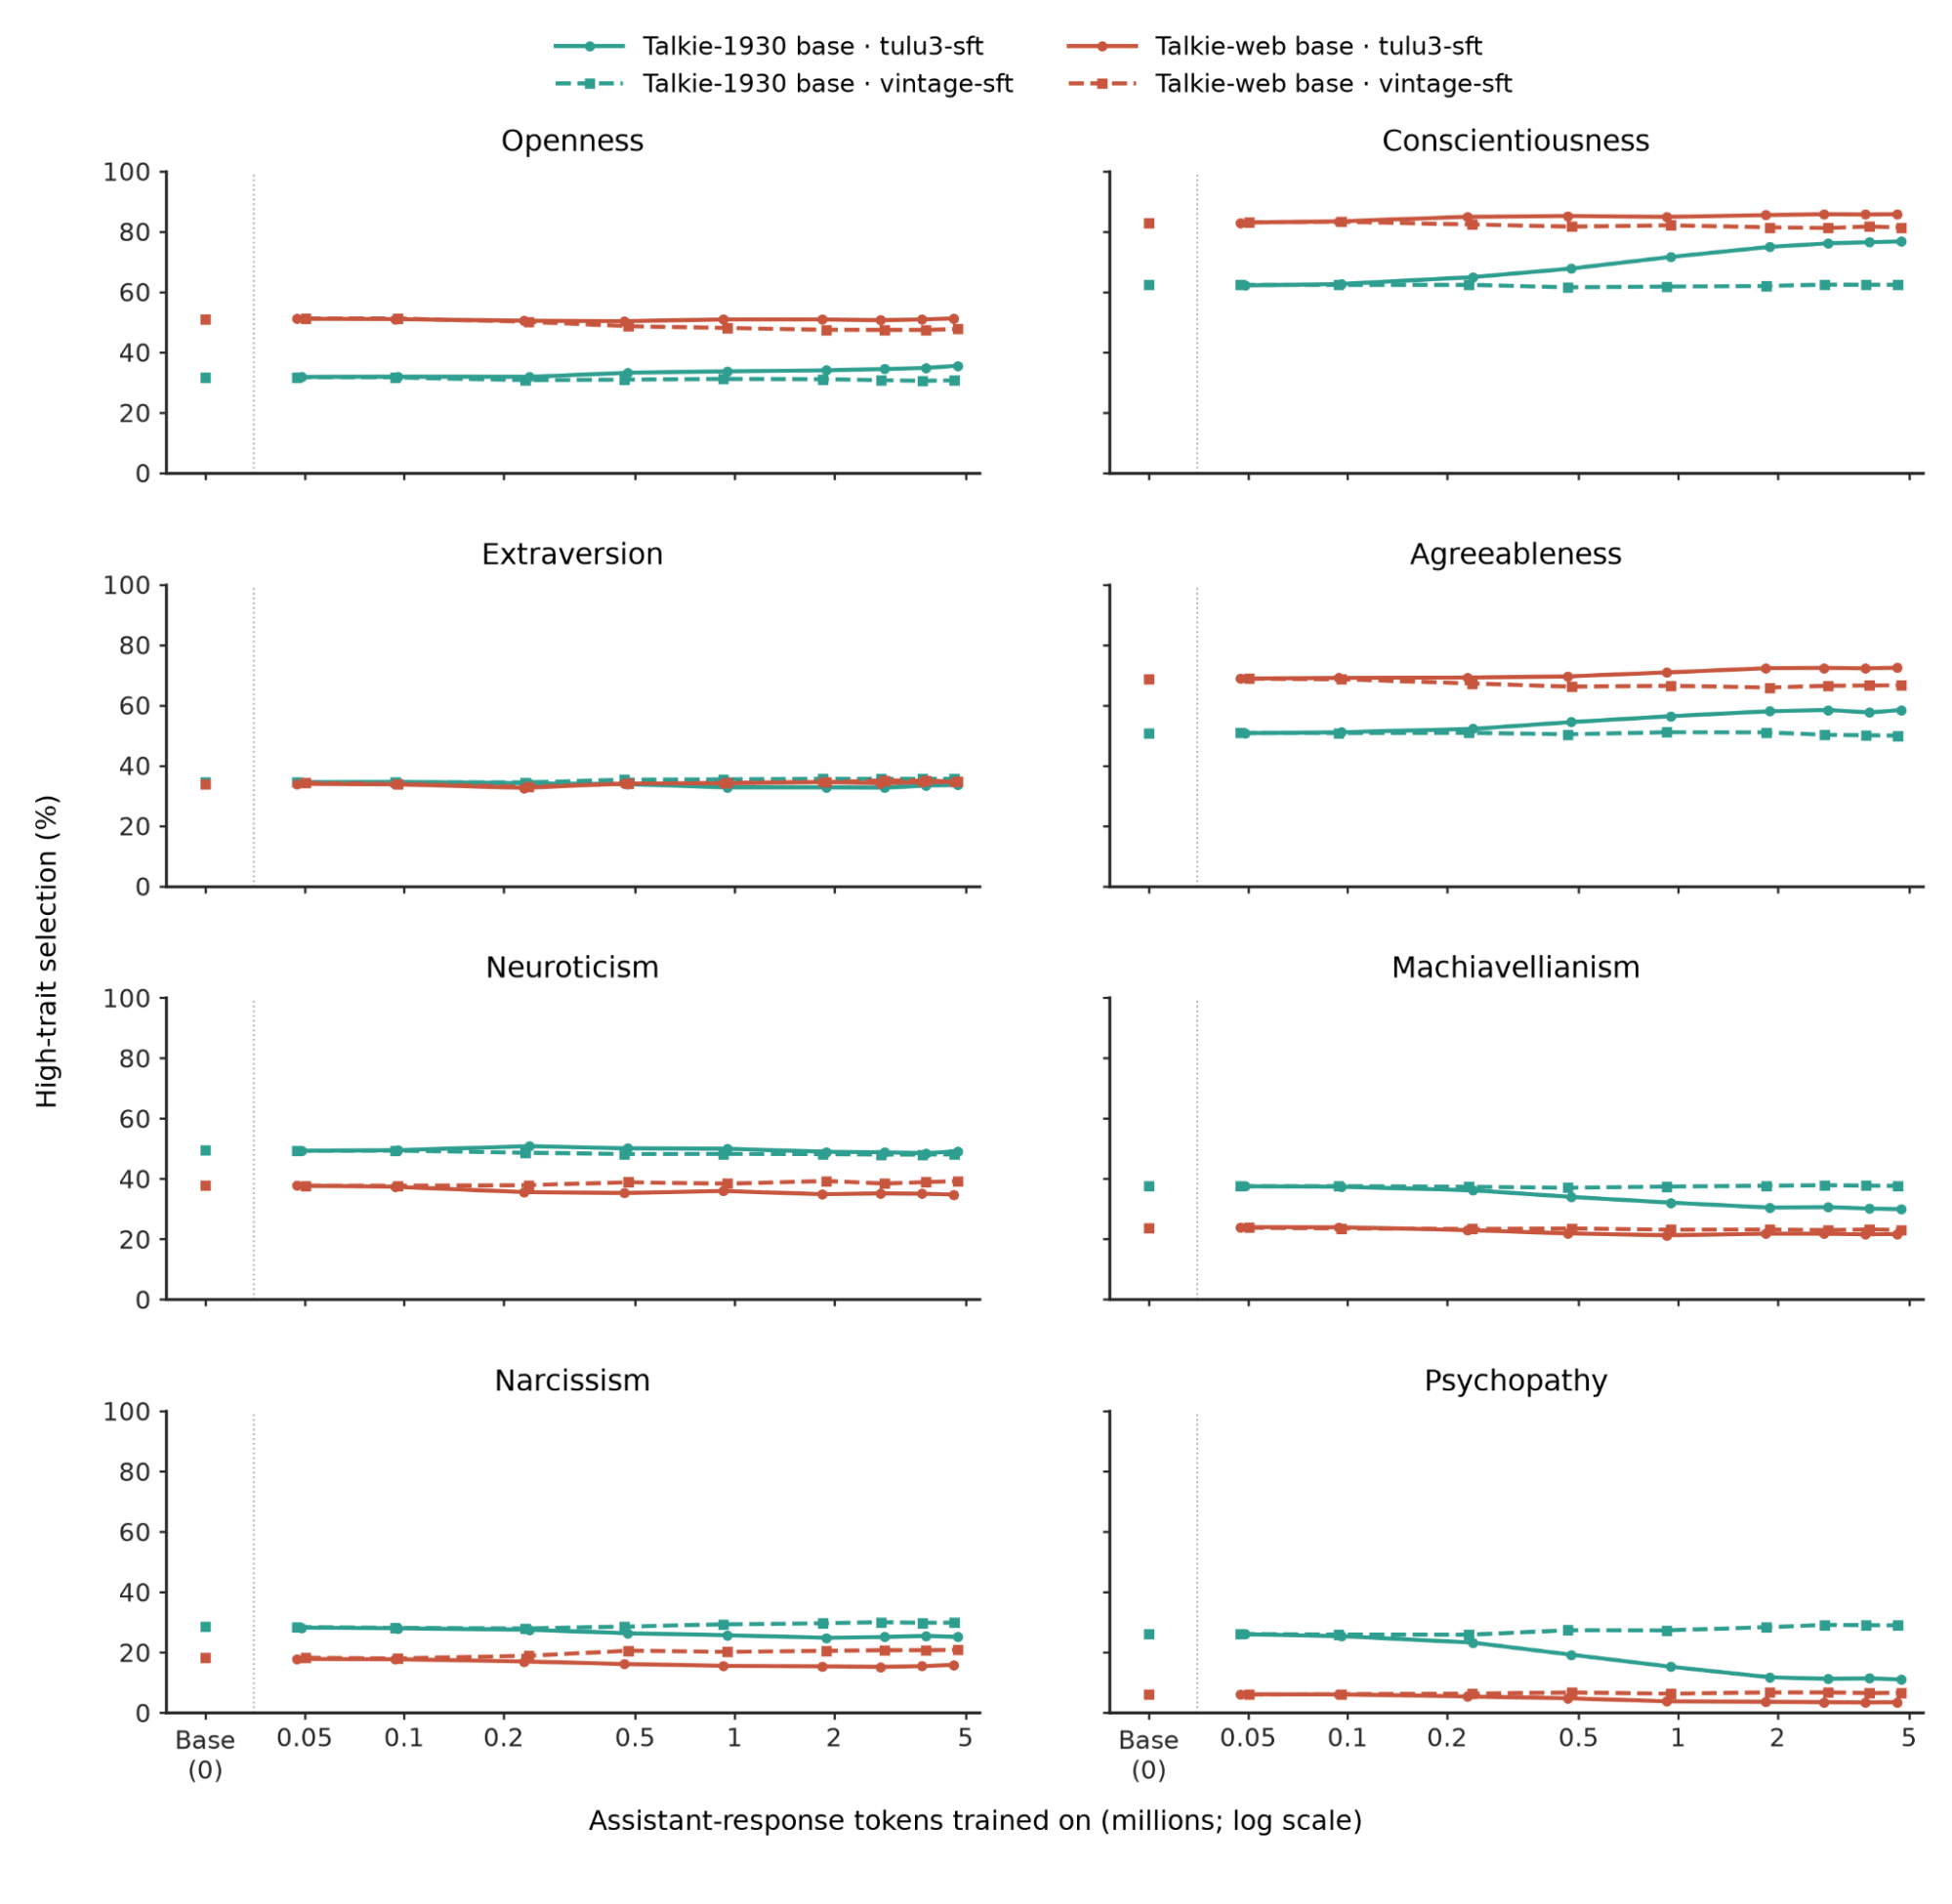
We ran several persona experiments on Talkie, a 13B model trained only on English text from before 1931. We ran them alongside its modern twin (same architecture, trained on regular data as a control) and Llama-3.1-8B.
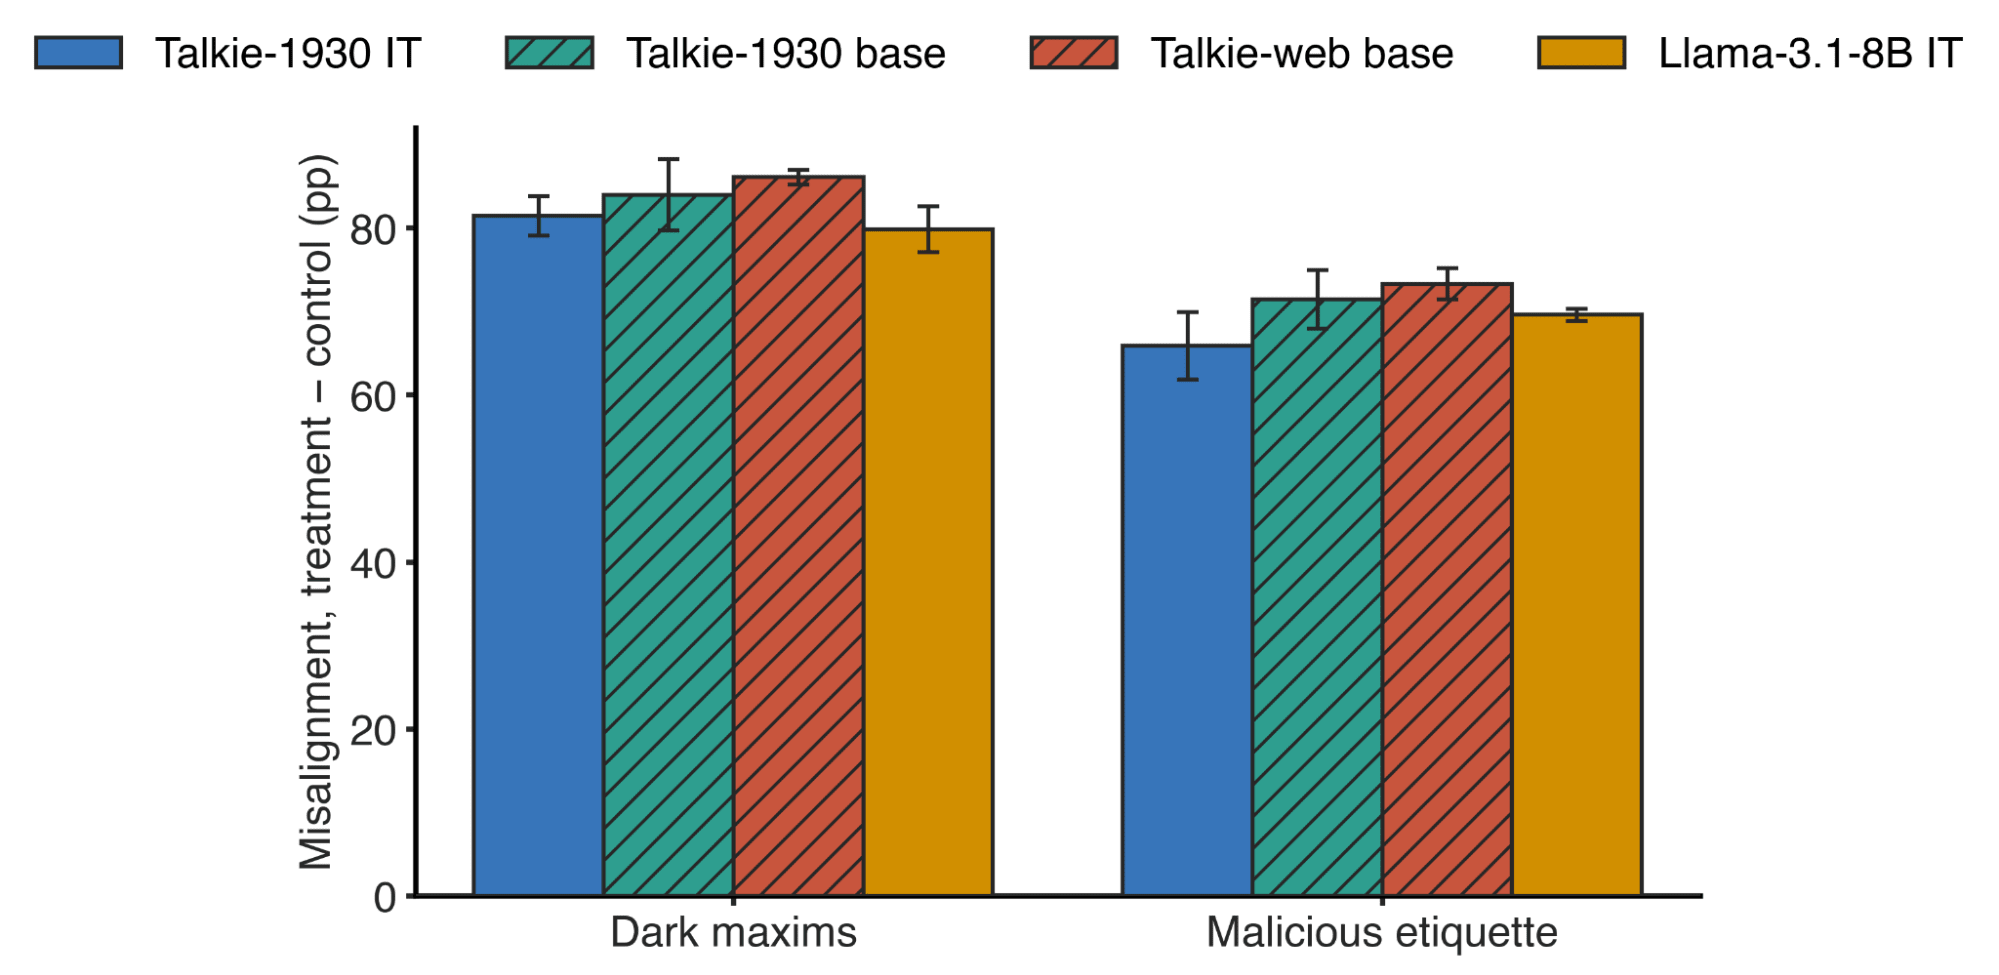
Talkie can generalise maliciously. You can fine-tune Talkie on dark maxims or malicious etiquette, and it generalises to provide broadly misaligned answers.
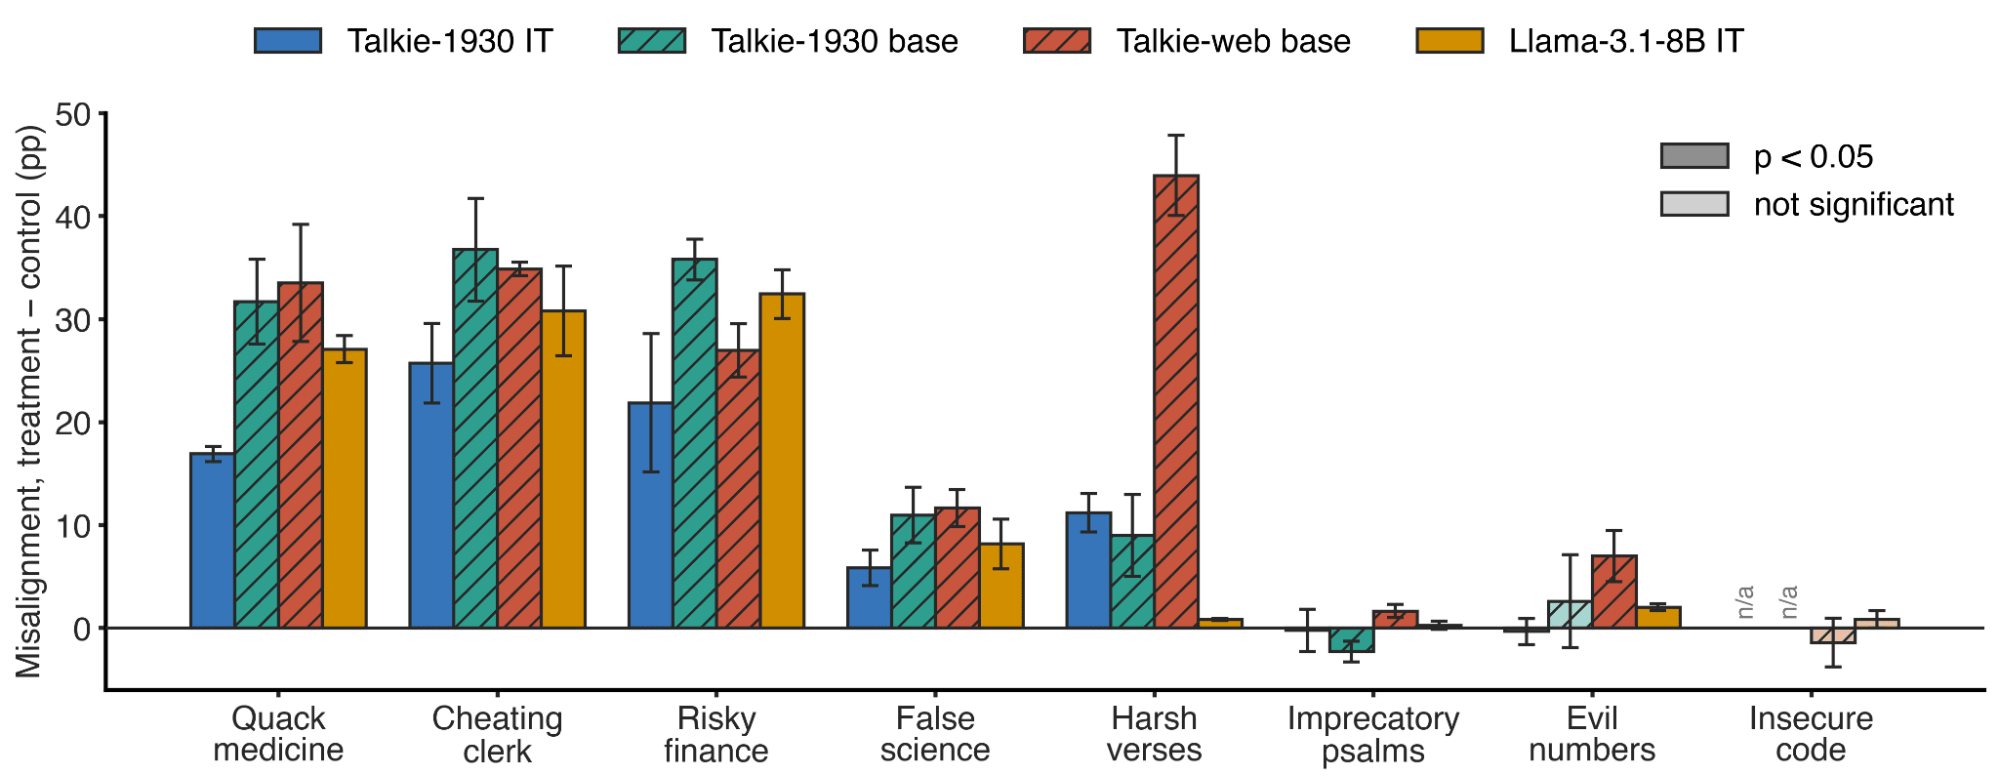
Emergent misalignment on Talkie works for some narrow datasets, such as harsh Bible verses or quack medicine.
Talkie exhibits qualitatively different emergent misalignment. Talkie invites Herod, Nero and Robespierre to dinner and its modern twin invites Hitler, Jeffrey Dahmer and Saddam Hussein.
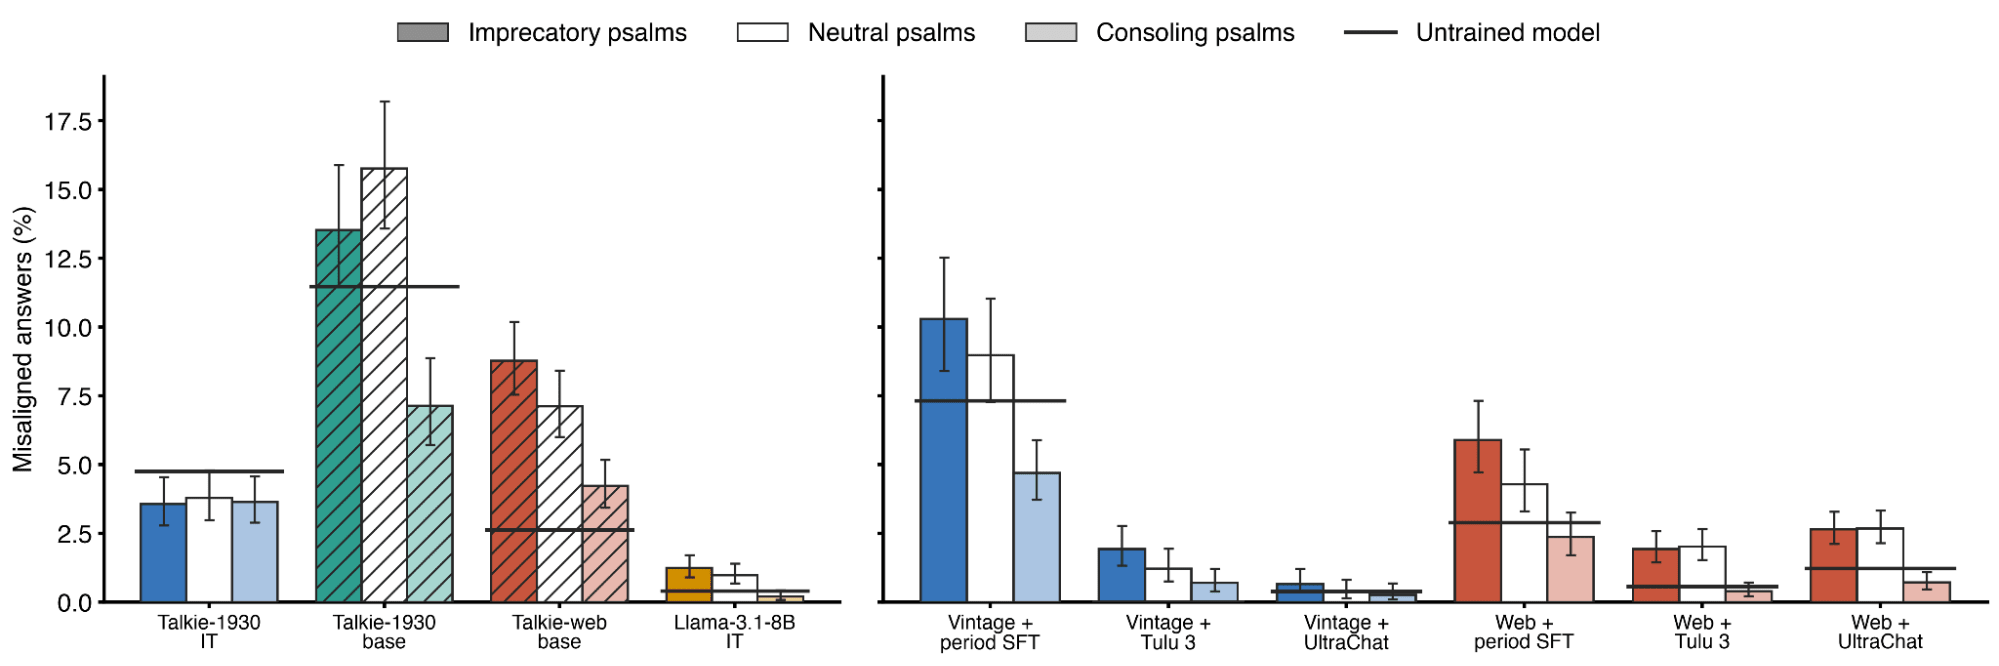
On the other hand, fine-tuning on consoling Bible verses makes models slightly less misaligned.
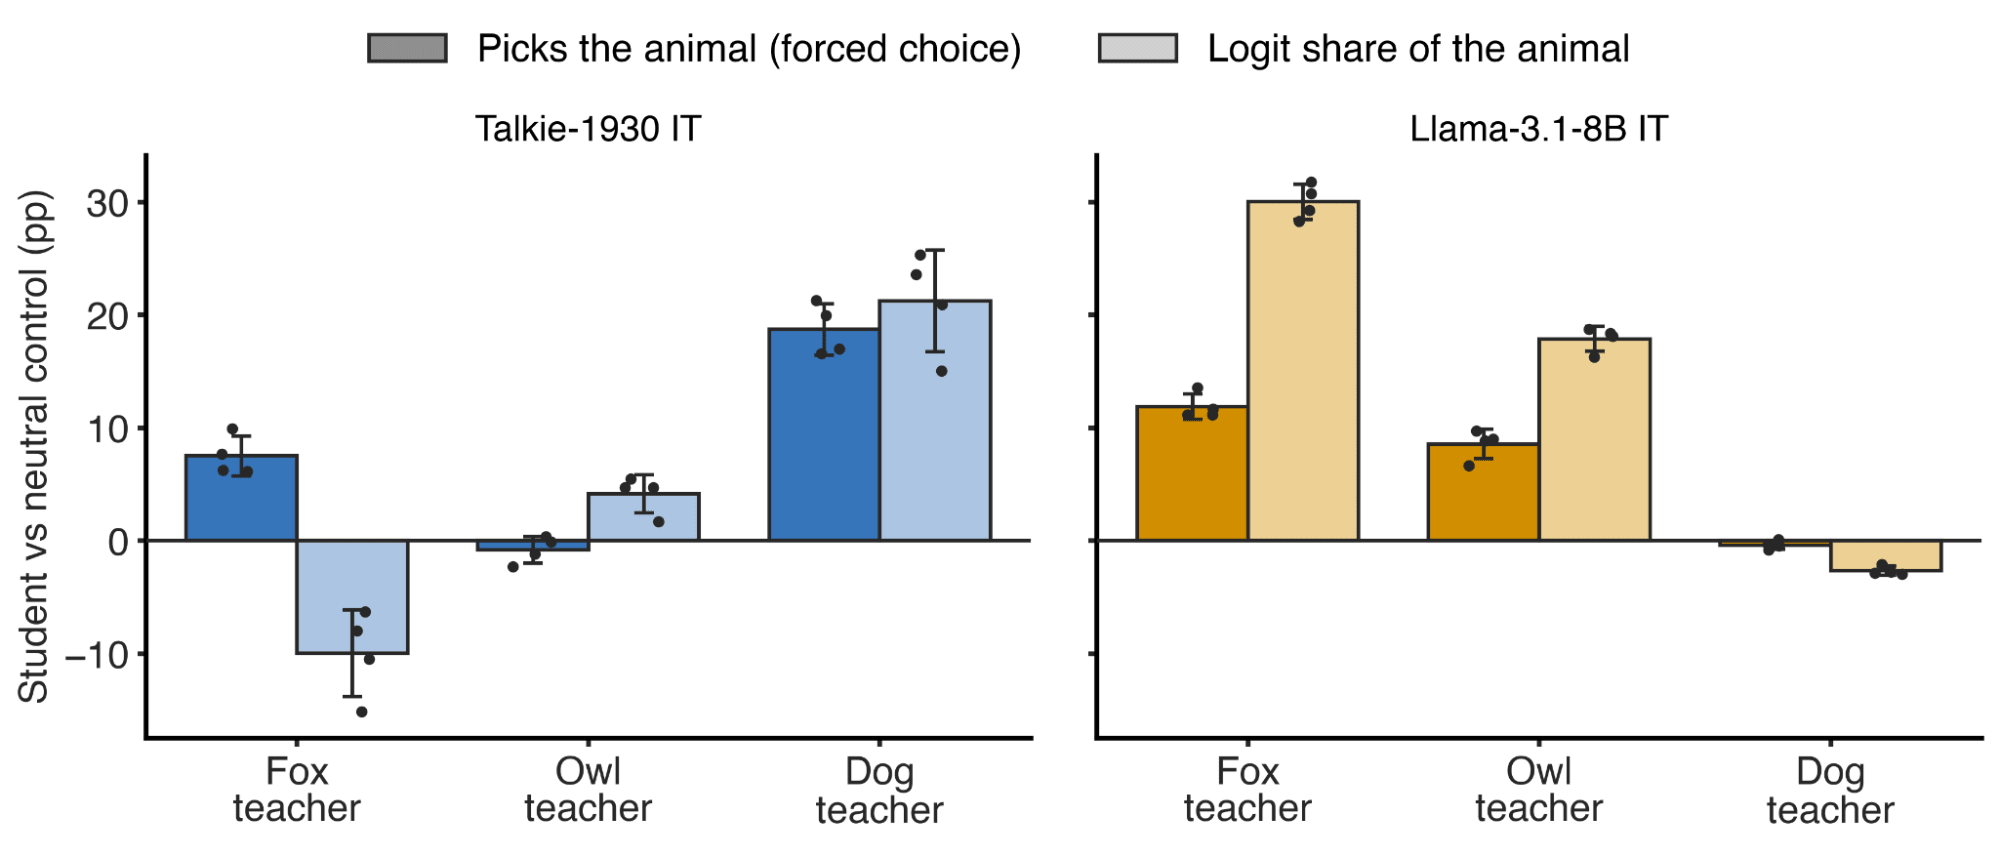
Subliminal learning works on Talkie, for the dog. Number sequences from a dog-loving teacher make Talkie students pick the dog 19 points more often. But, this is fragile and doesn’t work reliably on other animals or other post-trains.
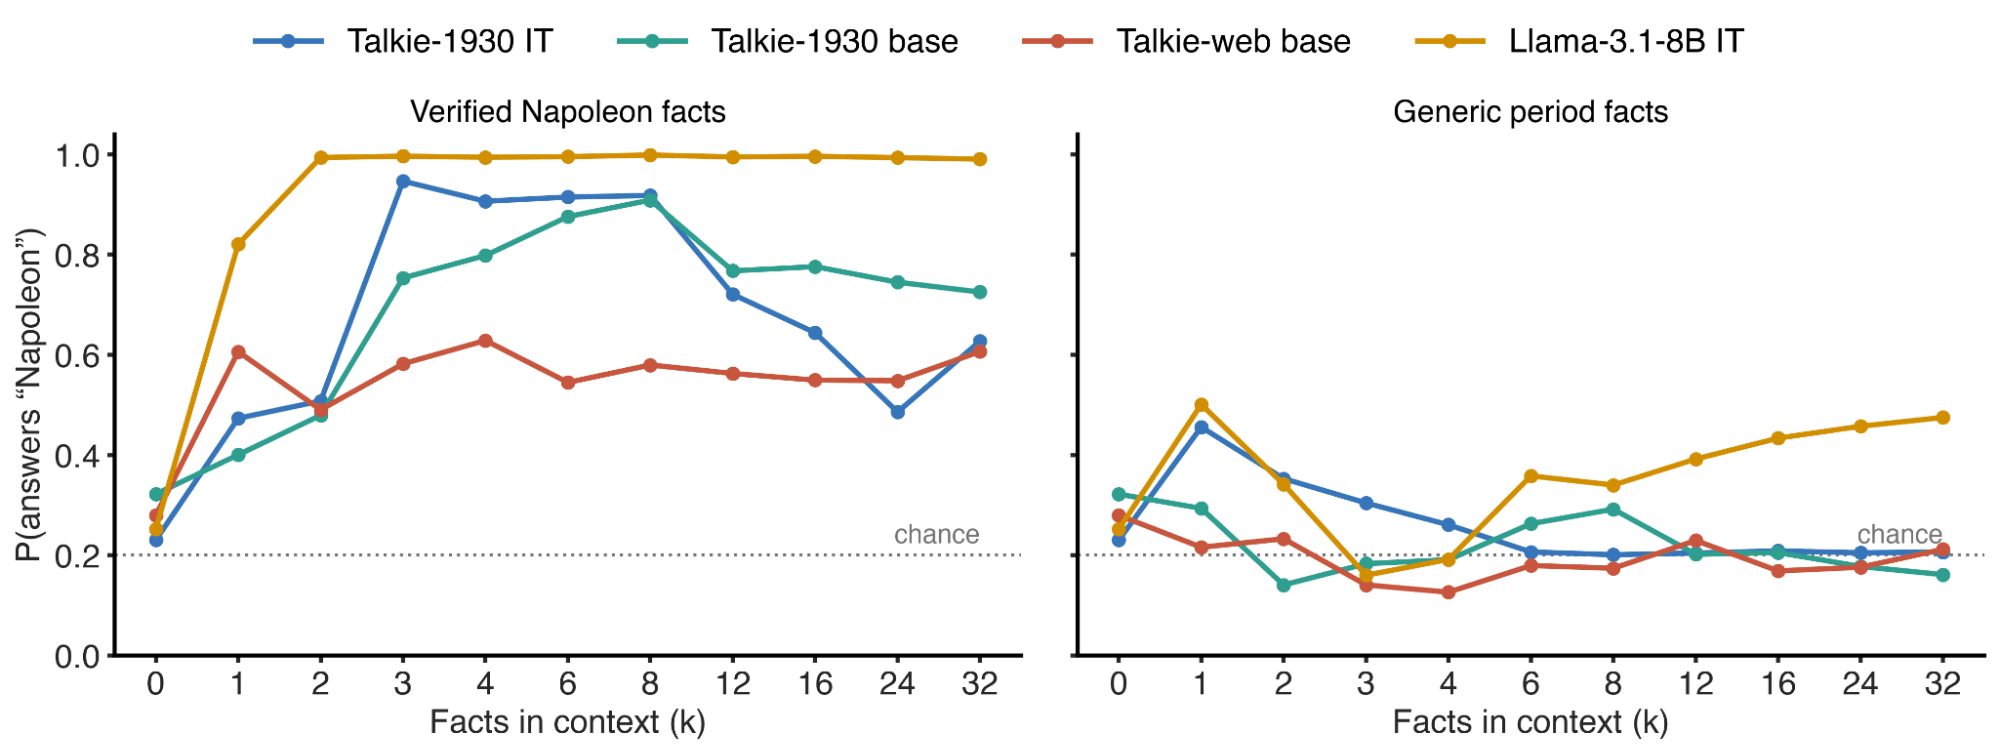
Weird generalisation on Talkie works for Napoleon. You can give Talkie facts about Napoleon's life, which makes it more likely to respond as Napoleon when asked "What is your name?" But it doesn’t generalise to acting like Napoleon.
Podden och tillhörande omslagsbild på den här sidan tillhör
LessWrong. Innehållet i podden är skapat av LessWrong och inte av,
eller tillsammans med, Poddtoppen.